Il funzionamento del percettrone si basa sul modello matematico di un singolo neurone: moltiplica ogni dato in ingresso per un peso, somma i prodotti, aggiunge un bias e passa il risultato a una funzione a soglia che risponde 1 oppure 0. Impara con un metodo iterativo: confronta la risposta con quella giusta e, quando sbaglia, corregge i pesi in proporzione all'errore. È l'algoritmo di classificazione binaria che Frank Rosenblatt presentò nel 1958, ed è il modello più semplice di rete neurale artificiale.
Se la domanda arriva da un quiz, la risposta in una riga è questa: il percettrone si basa su una somma pesata degli input confrontata con una soglia, e su pesi che si aggiornano a ogni errore finché le due classi non sono separate. E il primo percettrone era una macchina, non un programma: il Mark I, con 400 fotocellule e pesi regolati da motori elettrici.
Tutto quello che oggi si chiama intelligenza artificiale applicata al trading, dalle reti convoluzionali ai modelli linguistici, poggia su questa idea: un numero moltiplicato per un peso, sommato ad altri numeri, confrontato con una soglia. Cambiano la scala e la profondità, non il principio.
Chi ha inventato il percettrone e com'era il primo
Frank Rosenblatt era uno psicologo del Cornell Aeronautical Laboratory. Nel 1958 pubblica su Psychological Review l'articolo The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain, e poco dopo costruisce il Mark I Perceptron: una macchina fisica, con 400 fotocellule disposte in una griglia 20 per 20 come "retina" e pesi realizzati come potenziometri girati da motorini elettrici durante l'apprendimento.
La stampa dell'epoca lo racconta come l'embrione di un cervello elettronico. L'entusiasmo dura poco, per il motivo tecnico che vedremo più avanti. La ricostruzione storica, con i documenti originali, è pubblicata dalla stessa Cornell University.
Due date chiudono il quadro: nel 1962 Albert Novikoff dimostra il teorema di convergenza, cioè che su dati linearmente separabili il percettrone trova sempre una soluzione in un numero finito di passi. Nel 1969 Marvin Minsky e Seymour Papert pubblicano Perceptrons e mostrano il limite che ne frena lo sviluppo.
Su cosa si basa il funzionamento del percettrone: i cinque elementi
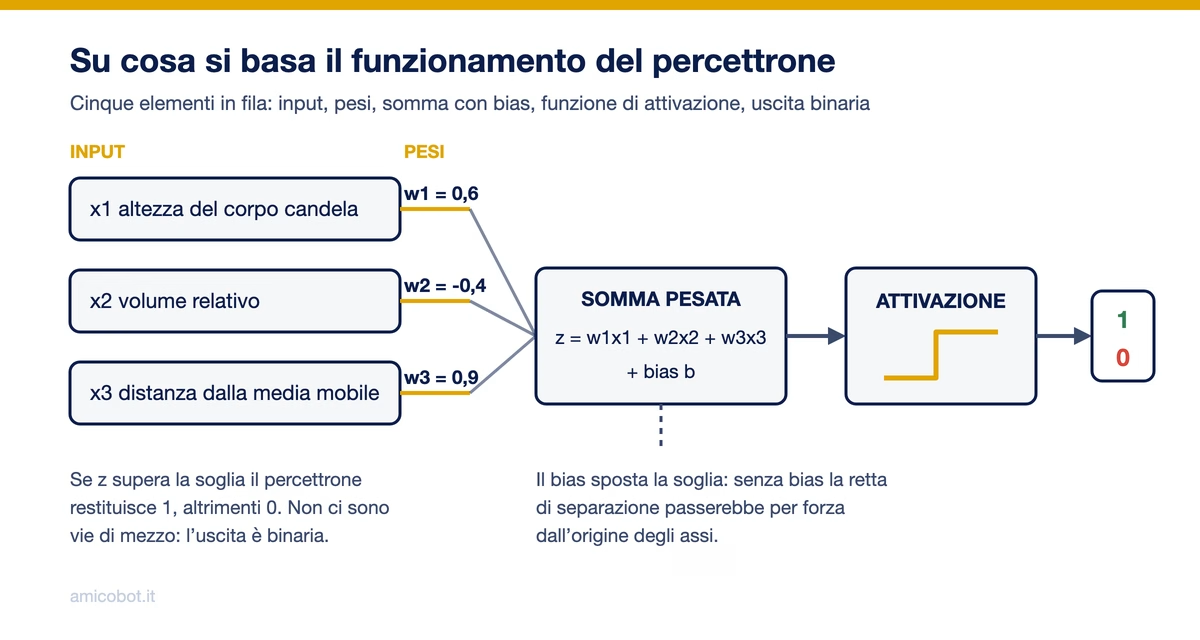
Il funzionamento si basa su cinque elementi in sequenza: gli input, i pesi, la somma pesata con il bias, la funzione di attivazione e l'uscita binaria. Non c'è altro. La differenza fra un percettrone e una rete profonda è la quantità di questi blocchi, non la loro natura.
Elemento
Cosa fa
Esempio applicato a una candela di mercato
Input (x)
I dati in ingresso, uno per caratteristica
Variazione della candela, volume relativo, distanza dalla media mobile
Pesi (w)
Quanto conta ciascun input nella decisione
Un peso alto sul volume significa che il modello si fida molto del volume
Bias (b)
Sposta la soglia, indipendentemente dagli input
Rende il modello più o meno incline a rispondere 1
Funzione di attivazione
Trasforma il numero in una decisione
Se la somma è maggiore o uguale a zero esce 1, altrimenti 0
Uscita (y)
Il risultato, sempre binario
Giornata classificata come rialzista oppure no
La formula è una riga sola:
y = f( w1·x1 + w2·x2 + … + wn·xn + b )
dove f è la funzione a gradino. Il peso della connessione, espressione che compare spesso nei quiz, è proprio il numero w che moltiplica ciascun input: nel neurone biologico corrisponde alla forza della sinapsi, nel percettrone è l'unica cosa che cambia durante l'apprendimento insieme al bias.
Un chiarimento che manca quasi ovunque: il bias del percettrone è un parametro numerico, non ha niente a che vedere con i bias cognitivi del trader. Serve a una cosa sola, permettere alla retta di separazione di non passare per forza dall'origine degli assi.
Geometricamente il percettrone traccia un iperpiano, che in due dimensioni è una retta. Tutto quello che sta da un lato vale 1, tutto quello che sta dall'altro vale 0. È insieme la sua forza, perché lo rende leggibile, e il suo limite, perché una retta sola non basta quasi mai.
Come impara: un esempio passo passo, eseguito davvero
L'addestramento è un ciclo che si ripete su ogni esempio: calcola l'uscita, confronta con la risposta giusta, correggi i pesi in proporzione all'errore. La regola è:
w_nuovo = w_vecchio + η · (y_reale – y_predetto) · x
dove η (eta) è il tasso di apprendimento, cioè quanto è grande ogni correzione. Il bias si aggiorna allo stesso modo, come se fosse il peso di un input che vale sempre 1.
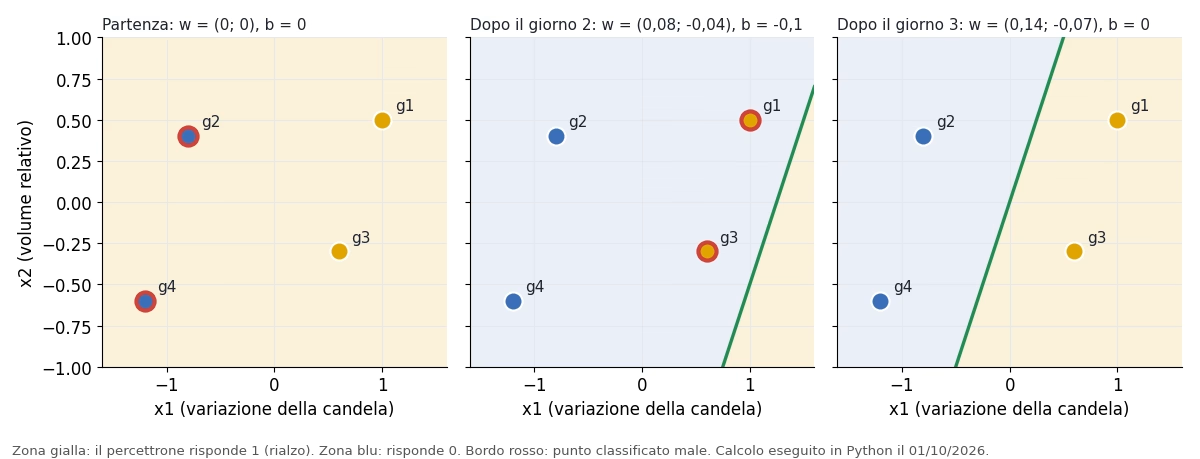
L'esempio usa quattro giornate di mercato con due caratteristiche: la variazione normalizzata della candela (x1) e il volume relativo rispetto alla media (x2). L'obiettivo y vale 1 se la seduta successiva ha chiuso in rialzo. Partenza: w1 = 0, w2 = 0, b = 0, η = 0,1. Il codice è stato eseguito in Python il 1 ottobre 2026 e la tabella è il suo registro, riga per riga.
Epoca
Giorno
x1
x2
z = w·x + b
Uscita
Atteso
Errore
w1
w2
b
1
1
1,0
0,5
0
1
1
0
0
0
0
1
2
-0,8
0,4
0
1
0
-1
0,08
-0,04
-0,1
1
3
0,6
-0,3
-0,04
0
1
+1
0,14
-0,07
0
1
4
-1,2
-0,6
-0,126
0
0
0
0,14
-0,07
0
2
1
1,0
0,5
0,105
1
1
0
0,14
-0,07
0
2
2
-0,8
0,4
-0,14
0
0
0
0,14
-0,07
0
2
3
0,6
-0,3
0,105
1
1
0
0,14
-0,07
0
2
4
-1,2
-0,6
-0,126
0
0
0
0,14
-0,07
0
Leggiamo le due correzioni.
Giorno 2, prima epoca. Con tutti i pesi a zero z vale 0, la soglia è "maggiore o uguale a zero" e l'uscita è 1, ma la risposta giusta è 0. L'errore è -1, quindi ogni peso si sposta di 0,1 · (-1) · x: w1 = 0 + 0,1·(-1)·(-0,8) = 0,08, w2 = 0 + 0,1·(-1)·0,4 = -0,04, b = 0 – 0,1 = -0,1.
Nella seconda epoca il modello non sbaglia più nulla e il ciclo si ferma: ha imparato con due sole correzioni, perché questi quattro punti sono separabili da una retta. Il grafico mostra la stessa cosa nello spazio dei dati: il confine verde è la retta dove w1·x1 + w2·x2 + b vale zero, e ruota a ogni correzione.
Il codice completo sta in venti righe:
import numpy as np

X = np.array([ [ 1.0, 0.5], [ -0.8, 0.4], [ 0.6, -0.3], [ -1.2, -0.6]])
y = np.array([ 1, 0, 1, 0])

w = np.zeros(2)
b = 0.0
eta = 0.1

for epoca in range(10):
    errori = 0
    for xi, target in zip(X, y):
        z = np.dot(w, xi) + b
        pred = 1 if z >= 0 else 0          # funzione a gradino
        delta = eta * (target - pred)      # regola di aggiornamento
        if delta != 0:
            w += delta * xi
            b += delta
            errori += 1
    if errori == 0:
        break

print(w, b)   # [ 0.14 -0.07] 0.0
Lo stesso percettrone su dati veri: 26 anni di S&P 500
L'esempio sopra funziona perché i quattro punti sono stati scelti per essere separabili. Per vedere cosa succede con i dati di mercato veri abbiamo dato allo stesso algoritmo le chiusure giornaliere dell'S&P 500 scaricate da Yahoo Finance, dal 2000 al 30 settembre 2026.
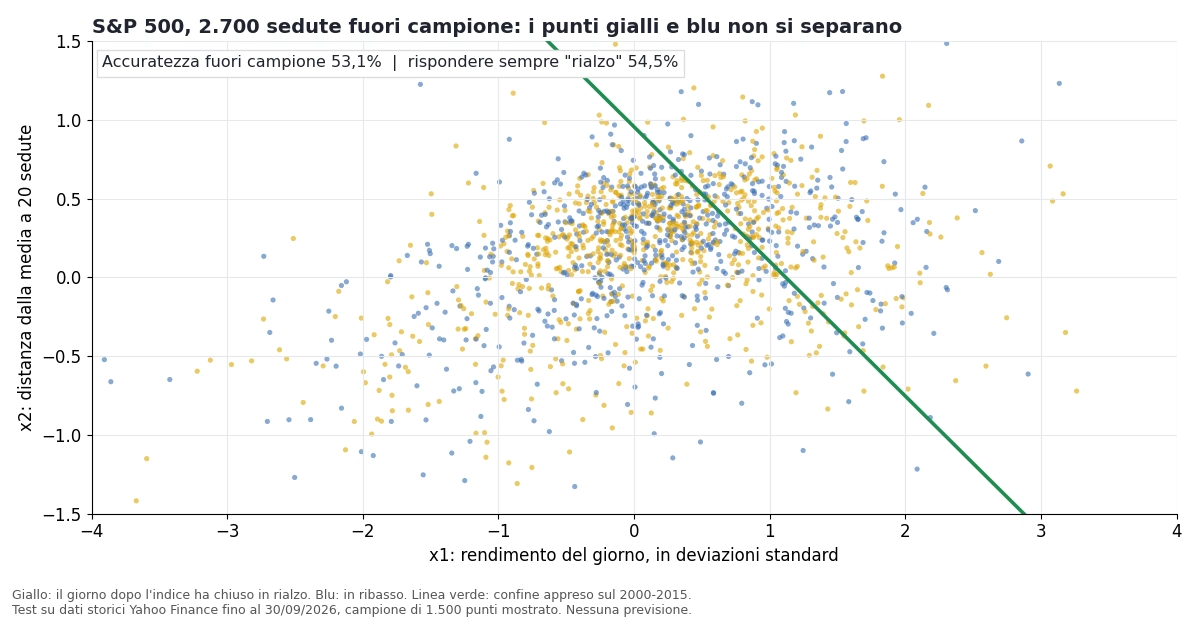
Il compito: dire se la seduta successiva chiuderà in rialzo (1) o in ribasso (0). Gli input: il rendimento del giorno, misurato in deviazioni standard degli ultimi 60 giorni, e la distanza del prezzo dalla media delle ultime 20 sedute. L'addestramento: 3.965 sedute dal 2000 al 2015, 20 passate sui dati con la regola di aggiornamento vista sopra, pesi mediati per stabilità. La verifica: 2.700 sedute dal 2016 al 2026, che il modello non ha mai visto.
Il risultato, eseguito il 1 ottobre 2026:
accuratezza sul periodo di addestramento 53,3%;
accuratezza fuori campione 53,1%;
una regola che risponde sempre "rialzo" sullo stesso periodo avrebbe indovinato il 54,5%, perché tanti sono stati i giorni di rialzo dal 2016;
il percettrone ha risposto "rialzo" nel 77% dei casi, e nelle 616 volte in cui ha risposto "ribasso" ha indovinato il 46,9%.
Risultato di una simulazione su dati storici giornalieri, senza costi di transazione, non di un conto reale; non è una previsione e i risultati passati non sono indicativi di quelli futuri.
Il grafico spiega il numero meglio di qualsiasi formula. I punti gialli e quelli blu stanno nella stessa nuvola: non esiste una retta che li separi, quindi il percettrone ne traccia una "di compromesso" che sbaglia quasi la metà delle volte. Con due input di prezzo e l'orizzonte di un giorno, il mercato non è linearmente separabile, ed è esattamente la condizione in cui il teorema di convergenza di Novikoff non promette niente: i pesi oscillano senza fermarsi.
Non è un difetto del percettrone. È quello che ci si deve aspettare da qualsiasi modello che riceve input poveri su un problema rumoroso, ed è il motivo per cui la sezione sul dato, più sotto, conta più del modello.
Il problema dello XOR: il limite che ha fermato le reti neurali per vent'anni
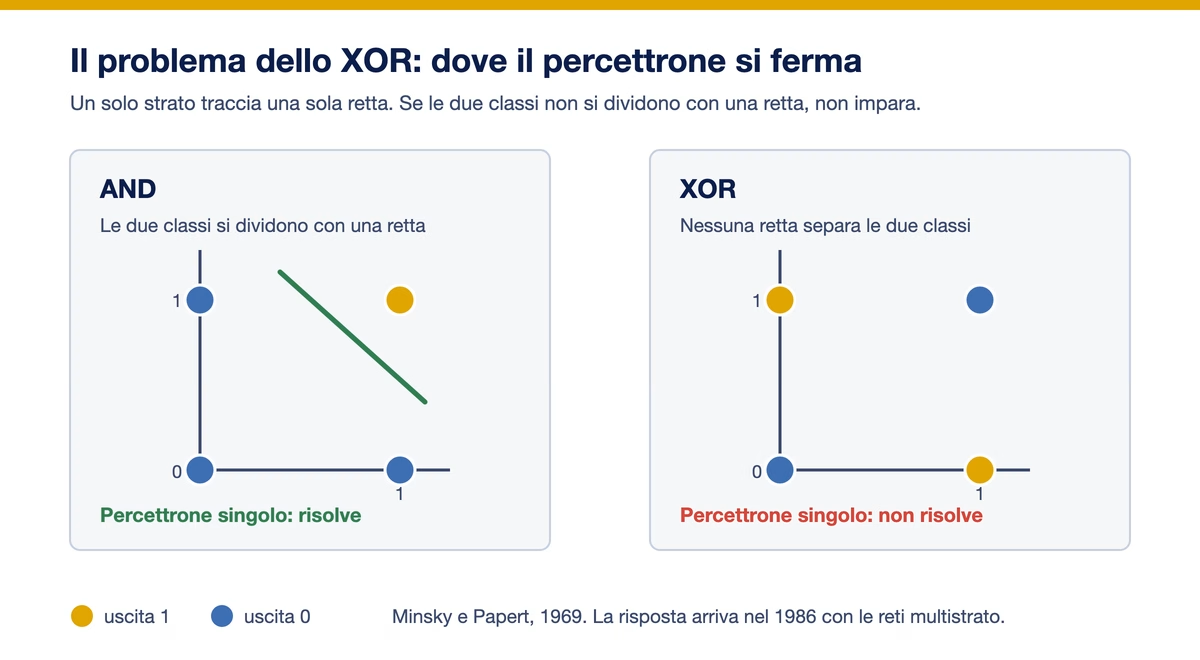
Nel 1969 Minsky e Papert dimostrano una cosa semplice e pesante: un percettrone a strato singolo non può imparare la funzione logica XOR. Lo XOR restituisce 1 quando i due input sono diversi e 0 quando sono uguali. Basta disegnare i quattro casi su un piano per vedere il problema: non esiste una retta capace di separare le due classi.
I finanziamenti alla ricerca sulle reti neurali si ridussero per quasi due decenni, il periodo che oggi si chiama inverno dell'intelligenza artificiale. La soluzione arriva nel 1986, quando Rumelhart, Hinton e Williams rendono praticabile la retropropagazione dell'errore e con essa le reti a più strati, che tracciano confini curvi e non più una sola retta.
Per chi lavora sui mercati non è una nota storica. È il motivo per cui un modello lineare non coglie una relazione non lineare, per quanti dati gli si diano. Se un fenomeno dipende dall'interazione fra due variabili e non dalla loro somma, serve un modello più profondo, oppure vanno costruite nuove caratteristiche che rendano il problema separabile.
Rispetto al percettrone, cosa hanno in più le reti neurali moderne
Tre cose: più strati (gli strati nascosti), funzioni di attivazione non lineari al posto del gradino, e un addestramento con la retropropagazione che corregge tutti i pesi insieme seguendo il gradiente dell'errore. Il risultato sono confini curvi e la possibilità di imparare relazioni come lo XOR. Il prezzo è la leggibilità: con migliaia di pesi non si capisce più quale input ha determinato la decisione. Il quadro completo è nella guida alle reti neurali.
Modello
Confine di decisione
Cosa restituisce
Costo di calcolo
Leggibilità del risultato
Perceptron
Una sola retta o iperpiano
Classe secca, 0 oppure 1
Molto basso
Alta, i pesi si leggono uno per uno
Regressione logistica
Una sola retta o iperpiano
Una probabilità fra 0 e 1
Basso
Alta, con in più la misura di confidenza
SVM con kernel
Lineare oppure curvo
Classe, con il margine più ampio possibile
Medio
Media
Perceptron multistrato (MLP)
Curvo, su più strati
Classe binaria o multiclasse
Alto
Bassa, è una scatola nera
La regressione logistica merita una riga in più: usa lo stesso schema lineare del percettrone ma restituisce una probabilità invece di una risposta secca. In un sistema automatico è una differenza sostanziale, perché una probabilità si può usare come filtro ("opero solo sopra il 70% di confidenza"), mentre uno 0 o un 1 no.
Delle varianti del modello base, due portano dritte alle tecniche di oggi. Il percettrone con margine cerca la retta che tiene i punti il più lontano possibile dal confine, ed è l'idea da cui nascono le SVM. Il kernel perceptron proietta i dati in uno spazio a più dimensioni, dove un problema non separabile può diventarlo.
Il perceptron nel trading automatico: cosa fa davvero e cosa no
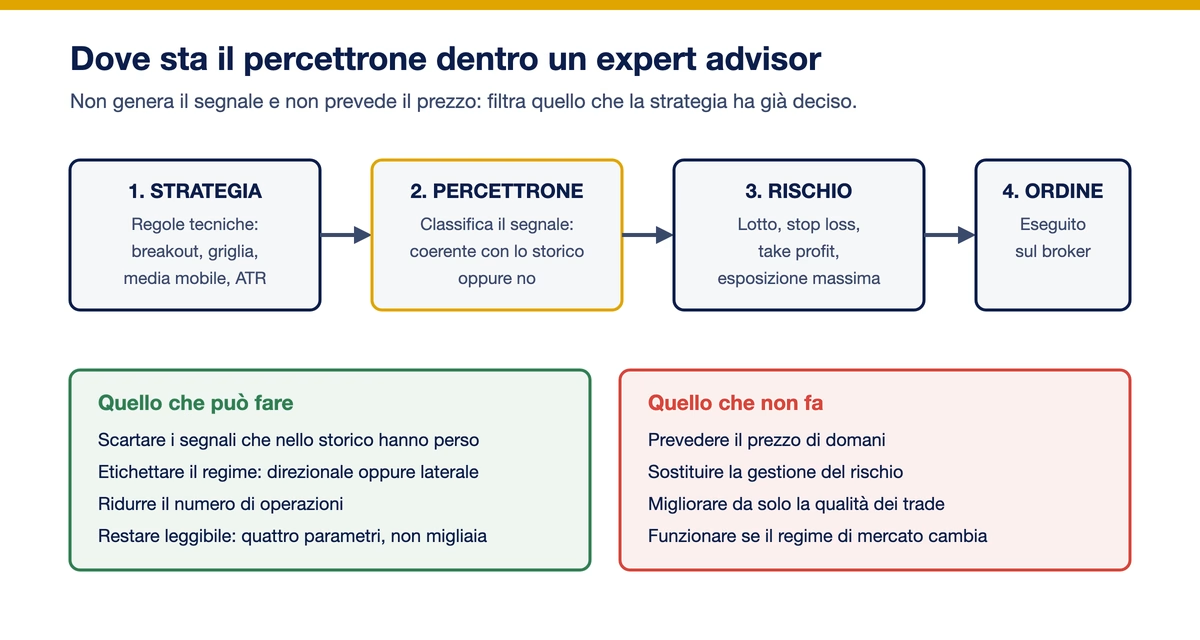
Qui serve chiarezza, perché è la parte su cui il marketing dei bot lavora di più. Il test sull'S&P 500 lo ha appena mostrato: il percettrone non prevede il prezzo. Classifica, e basta. In un sistema automatico può fare tre cose:
filtrare i segnali generati da una logica tecnica già esistente, scartando quelli che il modello classifica come sfavorevoli;
etichettare il regime di mercato, per esempio distinguere le fasi direzionali da quelle laterali;
classificare la singola candela o il singolo setup come coerente o no con lo storico.
In tutti e tre i casi resta un componente dentro un sistema più grande, mai il sistema stesso. È la stessa logica degli approcci di trading quantitativo più solidi, quelli di cui Jim Simons ha fatto una scuola: modelli semplici, tanti, combinati fra loro.
Un dato nostro: la parola "reti neurali" non predice il voto
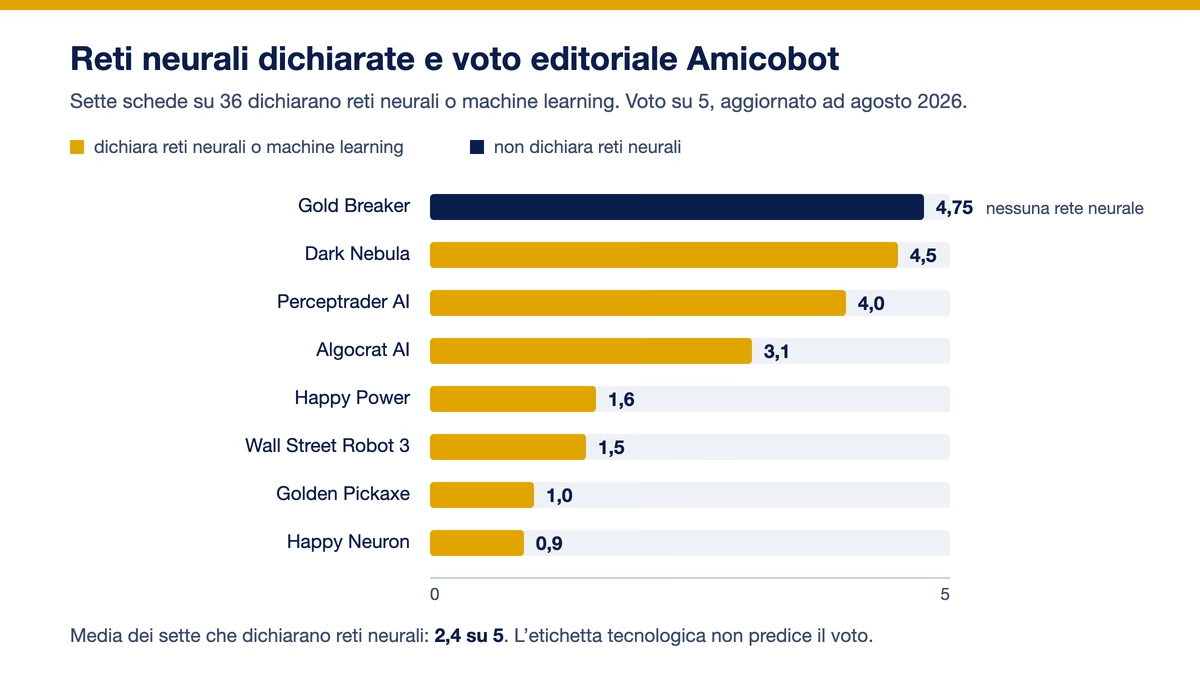
Nel nostro listino ci sono 36 schede di bot recensiti (conteggio al 1 ottobre 2026). Sette dichiarano di usare reti neurali o machine learning. La media dei loro voti editoriali è 2,4 su 5, con una dispersione enorme, da 4,5 a 0,9.
Nella stessa lista il punteggio più alto è di Gold Breaker, 95 su 100, pari a 4,75 su 5, e quel sistema non usa alcuna rete neurale: è un breakout sull'oro con sette strategie indipendenti e money management automatico. Il metodo con cui assegniamo questi voti è pubblico ed è descritto nei criteri con cui valutiamo gli algoritmi.
La lettura è semplice: l'etichetta tecnologica non dice nulla sulla qualità del sistema. Quello che la dice sono trasparenza del produttore, storico verificabile e gestione del rischio.
I tre casi concreti nel nostro listino
Perceptrader AI di Valery Trading è l'unico expert advisor del listino che dichiara esplicitamente il modello perceptron. Lo usa come filtro sopra una strategia a griglia, che apre una nuova posizione ogni 25 pip circa e non prevede uno stop loss tradizionale. Rapporto rischio rendimento dichiarato 1:2, profit factor 1,51, media editoriale 4 su 5. La nostra scheda riporta un'osservazione dalle prove fatte sul sistema che vale più di qualsiasi brochure: attivando il modulo di reti neurali il numero di operazioni si riduce sensibilmente, ma la qualità delle operazioni non migliora in modo sostanziale. Nelle prove è stato applicato uno stop loss sull'equity al 10% e sono state escluse NZD/USD, USD/CAD e GBP/CHF, troppo direzionali per una logica a griglia. Dati letti dalla scheda del produttore e dalla scheda Amicobot; i risultati passati non sono indicativi di quelli futuri e ogni sistema automatico comporta il rischio di perdita del capitale.
Dark Nebula di VENUS LABS è il caso più interessante. Usa il machine learning come strato accessorio sopra una logica tecnica classica su EUR/USD e GBP/USD in H1, basata su un uso non convenzionale dello stocastico e sull'ATR: l'algoritmo migliora la selezione degli ingressi, non li genera. Media editoriale 4,5 su 5, il voto più alto fra i sistemi che dichiarano componenti di apprendimento automatico.
Happy Neuron di Happy Forex mostra il rischio contrario. Dichiara reti neurali e analisi del sentiment di mercato, profit factor 1,73 sulla carta, ma la nostra valutazione si ferma a 0,9 su 5 perché trasparenza e risultati verificabili sono valutati al 10%. Il nome contiene la parola "neurone", il track record non è controllabile.
Cosa raccontano gli utenti che hanno comprato un EA a reti neurali
Le opinioni sui bot che dichiarano reti neurali si trovano dove chi li ha comprati lascia traccia. Il 30 agosto 2026 abbiamo letto le pagine MQL5 di tre expert advisor che dichiarano un percettrone o una rete neurale, più i commenti di due video italiani sul trading automatico con AI; il 1 ottobre 2026 abbiamo ricontrollato la pagina di Perceptrader AI. Il campione: 7 recensioni e 30 commenti su Perceptrader AI MT5 (numeri invariati al 1 ottobre), 69 recensioni e 56 commenti su Aura Neuron MT5, 5 recensioni e 14 commenti su AI Perceptron per MT4, più due video YouTube da 48.000 e 211.000 visualizzazioni. Le voci sotto sono riportate come le abbiamo lette, con username e data pubblici. Sono dichiarazioni degli utenti, non dati verificati alla fonte.
Quello che funziona, raccontato da chi lo usa.ken, sulla pagina di Perceptrader AI il 13 ottobre 2023, dichiara oltre due mesi di utilizzo e indica proprio il filtro AI come la parte che funziona meglio. kasaby123, sulla stessa pagina il 2 aprile 2026, scrive di molti parametri da regolare in base alla tolleranza al rischio e di un risultato positivo da oltre un anno. Doug, su MQL5 il 9 febbraio 2025, racconta 17 operazioni su 17 chiuse in utile su Aura Neuron, con un rischio dell'1,75% per operazione e lo stop abbassato a 27,5 dollari dai 39 di default. caimano93, il 16 febbraio 2026, è l'unico a dichiarare la dimensione del proprio campione: dieci giorni di test, configurazione conservativa, poche operazioni, e la frase che chiude tutto, siamo ancora presto nei test.
Quello che si rompe.samimql, su Perceptrader AI il 23 agosto 2023, lascia 2,5 stelle: il supporto risponde con troppo ritardo rispetto al prezzo del prodotto. Daniel Chait, su MQL5 il 9 maggio 2025, segnala che la versione 1.51 di Aura Neuron non apre operazioni su tre piattaforme MT5 diverse. lgxzm, l'8 aprile 2025, chiede sulla stessa pagina perché l'EA non abbia registrato alcun ordine in due giorni. AdvanceFxRobot, su Perceptrader AI il 31 luglio 2023, non trova il pulsante di attivazione della VPS descritto nel video del produttore. Il problema più frequente non è la rete neurale, è il software che non parte.
Quello che dicono gli spettatori italiani. Sotto il video di Giuseppe Castagna in cui un bot costruito con l'AI genera segnali per sette giorni, i commenti più votati fanno tutti la stessa obiezione di metodo. @it.shifty, ad aprile 2026, con 166 like: lascialo su un altro mese, vogliamo vedere i risultati dopo un mese. @dorcondorcon, stesso periodo, 80 like: il risultato della settimana va verificato su un anno intero prima di chiamarlo un risultato. @albertos.8556, a maggio 2026, nota che manca uno stop alla discesa e che con guadagni dell'8% e perdite dell'11% può essere stata anche fortuna. Nell'altro video, quello di Simone Rizzo, i commenti sono quasi solo entusiasmo per la serie annunciata e non contengono resoconti d'uso. Sono osservazioni di spettatori, non performance verificate, e i risultati passati non sono indicativi di quelli futuri.
Il conteggio che nessuno pubblica. Dei 30 commenti sulla pagina MQL5 di Perceptrader AI, 27 sono richieste di accesso al gruppo Telegram e risposte dello sviluppatore, uno solo segnala un problema tecnico e nessuno riporta un risultato operativo con numeri. Fra le 7 recensioni, una porta la data del giorno stesso di pubblicazione del prodotto, il 24 luglio 2023, ed è di un acquirente che dichiara di essere stato fra i primissimi a comprarlo: entusiasmo sulla fiducia, non esperienza d'uso. Su AI Perceptron per MT4 il quadro è simile: prodotto pubblicato il 14 dicembre 2024, 5 recensioni in totale e 217 download della demo, le tre visibili lunghe una riga (sbanking il 2 gennaio, Bifrost il 10, AlphaMedic il 22 gennaio 2025), tutte nelle cinque settimane successive all'uscita.
L'ammissione più interessante arriva dallo sviluppatore. Il 21 luglio 2025Stanislav Tomilov, autore di Aura Neuron, spiega sulla pagina del prodotto perché le operazioni in perdita possono sparire dal backtest dopo un riaddestramento della rete neurale: la rete riscrive i propri parametri, impara a evitare i trade che nello storico avevano perso, e la cronologia del backtest cambia. Sostiene che sia la natura del machine learning, non una manipolazione. Ha ragione a metà: riaddestrare produce un modello nuovo, quindi trade diversi. Ma un backtest che migliora ogni volta che il modello viene riaddestrato sugli stessi dati non è più una verifica, è la misura di quanto bene il modello ha memorizzato il passato. È esattamente ciò che il nostro test sull'S&P 500 evita separando il periodo di addestramento da quello di verifica.
Il problema vero non è il modello, è il dato
Un percettrone addestrato su dati di mercato impara la separazione su quel campione. Se il campione contiene un regime che poi cambia, i pesi restano tarati su un mondo che non esiste più. È il meccanismo per cui un sistema si adatta al rumore invece che al segnale, e su serie finanziarie succede molto più in fretta che in altri domini.
Le contromisure sono note e non sono opzionali: separare i dati di addestramento da quelli di verifica (in sample e out of sample), validare con l'ottimizzazione walk forward, tenere il numero di parametri molto basso rispetto alle osservazioni, e confrontare sempre il modello con una regola banale. Nel test sopra il confronto con "rispondi sempre rialzo" è quello che rivela il risultato: senza, un 53% sembrerebbe un successo.
C'è anche un lato regolamentare. Il 30 maggio 2024 l'ESMA ha pubblicato una dichiarazione sull'uso dell'intelligenza artificiale nei servizi di investimento al dettaglio, indicando quattro rischi: distorsioni algoritmiche e qualità dei dati, opacità del processo decisionale, eccessiva dipendenza dall'AI, privacy e sicurezza dei dati. Il quadro generale europeo è quello del regolamento sull'intelligenza artificiale della Commissione europea.
Il modello resta in servizio dove il problema è davvero binario e i dati sono puliti: classificazione di testi come il filtro antispam, riconoscimento di forme semplici, controllo qualità industriale ("pezzo conforme oppure no") e soprattutto didattica, come primo passo per capire l'apprendimento supervisionato prima delle reti profonde.
Nel machine learning il percettrone rappresenta la famiglia dell'apprendimento supervisionato, quella in cui a ogni esempio corrisponde una risposta corretta. Le altre due grandi famiglie sono l'apprendimento non supervisionato, che raggruppa i dati senza etichette come nell'analisi dei cluster, e l'apprendimento per rinforzo, dove il modello impara dai premi e dalle penalità delle proprie azioni. Su serie storiche di prezzo le varianti del percettrone si combinano spesso con le tecniche previsionali sulle serie temporali e con l'elaborazione del linguaggio naturale applicata alle notizie, per costruire input che un modello lineare da solo non avrebbe.
Cornell University, ricostruzione storica del percettrone di Rosenblatt; ESMA, dichiarazione pubblica sull'uso dell'intelligenza artificiale nei servizi di investimento del 30 maggio 2024; Commissione europea, quadro normativo sull'intelligenza artificiale. Esempio passo passo e test sull'S&P 500 eseguiti in Python il 1 ottobre 2026 su dati giornalieri dell'API pubblica di Yahoo Finance (^GSPC) fino al 30 settembre 2026; script e registri nella cartella di ricerca del 1 ottobre 2026. Voti dei bot letti dalle schede recensione Amicobot il 1 ottobre 2026. Recensioni e commenti letti il 30 agosto 2026 sulle pagine MQL5 di Perceptrader AI MT5, Aura Neuron MT5 e AI Perceptron MT4 e nei commenti pubblici dei video YouTube citati; pagina di Perceptrader AI ricontrollata il 1 ottobre 2026. Questa pagina non contiene link di affiliazione; per alcuni expert advisor citati Amicobot ha rapporti commerciali dichiarati nella scheda del singolo bot. I contenuti hanno finalità informativa e non costituiscono consulenza finanziaria né una raccomandazione personalizzata di investimento; i risultati passati non sono indicativi di quelli futuri.
Disclaimer
Pagina informativa realizzata con l’aiuto dell’intelligenza artificiale: non è consulenza finanziaria, né una raccomandazione di investimento, né promozione di prodotti o servizi. Il trading di CFD comporta un elevato rischio di perdita del capitale e i risultati passati non sono indicativi di quelli futuri. Dati e prezzi valgono alla data di pubblicazione. Possibili link di affiliazione: AmicoBot può ricevere una commissione, senza costi aggiuntivi per te. Segnalazioni di errori qui.
Su una somma pesata degli input, più un bias, confrontata con una soglia da una funzione a gradino che restituisce 1 oppure 0. L'apprendimento si basa su un metodo iterativo: a ogni errore i pesi vengono corretti in proporzione all'errore e al valore dell'input. Geometricamente il modello traccia una retta, o un iperpiano, che divide i dati in due classi.
Una macchina. Il Mark I Perceptron, costruito da Frank Rosenblatt al Cornell Aeronautical Laboratory dopo l'articolo del 1958, aveva 400 fotocellule in una griglia 20 per 20 e pesi realizzati con potenziometri regolati da motori elettrici. Il percettrone era stato prima simulato su un computer IBM 704, ma la versione nota come "il primo percettrone" è l'hardware dedicato.
È il numero che moltiplica ciascun input prima della somma. Indica quanto quell'input conta nella decisione: un peso grande e positivo spinge verso l'uscita 1, uno negativo verso lo 0, uno vicino a zero rende l'input quasi irrilevante. Durante l'addestramento i pesi sono, insieme al bias, gli unici valori che cambiano.
Più strati di neuroni, funzioni di attivazione non lineari al posto del gradino e un addestramento con retropropagazione dell'errore. Questo permette confini di decisione curvi e la soluzione di problemi come lo XOR, che un percettrone singolo non può imparare. Il costo è una minore leggibilità e un rischio più alto di adattarsi al rumore dei dati.
Perché lo XOR richiede due rette per separare le classi e un percettrone singolo ne traccia una sola. Lo dimostrarono Minsky e Papert nel 1969. Il problema si risolve con il percettrone multistrato, praticabile dal 1986 grazie alla retropropagazione.